



Une étude montre que les chatbots médicaux, y compris ChatGPT et Gemini, offrent des diagnostics erronés dans 80 % des cas sans informations complètes.
Lara Maior


Connaissance IT&C
Yarrrrrbright/ Shutterstock.com

Retrouvez toujours nos actualités sur Google
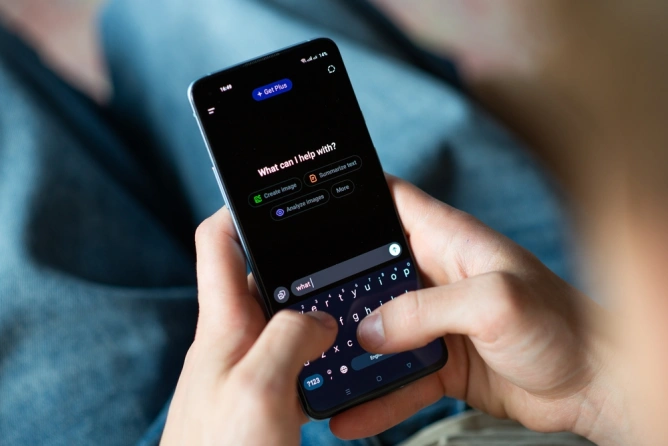
Une étude réalisée par Mass General Brigham dans le Massachusetts, publiée dans Jama Network Open, a mis en évidence que les chatbots ordinaires, tels que ChatGPT et Gemini, se trompent dans les diagnostics dans plus de 80 % des cas lorsqu'ils n'ont pas suffisamment d'informations sur les patients. L'étude a testé 21 modèles linguistiques, y compris ceux développés par OpenAI, Anthropic, Google, xAI et DeepSeek, en utilisant 29 vignettes cliniques basées sur des textes médicaux de référence. Même lorsqu'ils avaient accès à des informations complètes, les chatbots avaient un taux d'erreur de plus de 40 %, bien que dans certains cas, ils aient réussi à fournir le bon diagnostic pour 90 % des patients. La conclusion des expériences est que la performance de ces modèles dépend significativement du volume d'informations disponibles, et les hallucinations, c'est-à-dire l'invention d'informations, restent un problème majeur dans la génération de réponses correctes.
Sources


Dernières actualités
22:28
Ilie Bolojan, avertissement au gouvernement Niculescu : le PNL sanctionnera les dérapages budgétaires
21:57
Alexandru Rogobete annonce un programme national visant à réduire les infections nosocomiales
21:23
Les forces lettones ont alerté la population après qu’un objet non identifié est entré dans l’espace aérien national, près des frontières avec la Russie et la Biélorussie
21:02
Iliana Iotova en tête de l’élection présidentielle en Bulgarie, selon les sondages réalisés à la sortie des urnes
20:51
Un minibus transportant 18 personnes s’est renversé dans le département de Iași / Les autorités ont activé le Plan rouge d’intervention
Voir plus d’actualités
ACTUALITÉS SUR LES MÊMES SUJETS

Fil d’actualités personnalisé, recherche optimisée par IA et notifications dans une expérience plus interactive.


