

OpenAI investighează cauzele pentru care modelele lingvistice avansate, precum GPT-5, provoacă hallucinații
Gabriel Dumitrache


Știință IT&C
Foto: Shutterstock

Vezi mereu știrile noastre în Google
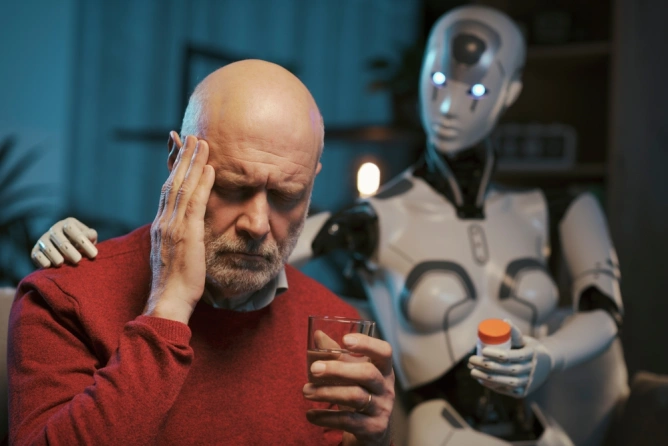
Un nou studiu de la OpenAI explorează fenomenul hallucinațiilor în modelele lingvistice mari (LLM), cum ar fi GPT-5. Hallucinațiile sunt definite ca afirmații plauzibile dar false generate de aceste modele. Cercetătorii subliniază că problema provine din modul în care LLM-urile sunt pre-antrenate, optimizate pentru a prezice următorul cuvânt fără a distinge între adevăr și fals. Evaluările actuale, care se concentrează pe acuratețe, încurajează modelele să ghicească în loc să recunoască incertitudinea. Studiul sugerează că metodele de evaluare ar trebui să evolueze pentru a penaliza răspunsurile greșite și a recompensa exprimarea îndoielii, pentru a reduce hallucinațiile.

Ultimele știri
16:36
O femeie de 67 de ani, suspectată de implicare într-o schemă de escrocherie, a fost reținută în flagrant de polițiști
16:35
Angela Merkel, desemnată reprezentanta Uniunii Creștin-Democrată / Fostul cancelar va participa la alegerea președintelui Germaniei
16:33
Elena Udrea susține că primarii și șefii de consilii județene PNL pregătesc înlocuirea lui Ilie Bolojan de la conducerea partidului
16:32
Liceenii francezi au reluat protestele după vacanță, dar la scară mai mică
16:32
Federația „Solidaritatea Sanitară” îi cere ministrului Muncii negocieri pentru noua Lege a salarizării
Vezi mai multe știri
ȘTIRI PE ACELEAȘI SUBIECTE
.webp)

Feed personalizat de știri, căutare cu Inteligență Artificială și notificări într-o experiență mai interactivă.