Uno studio mostra che i chatbot medici, inclusi ChatGPT e Gemini, forniscono diagnosi errate nell'80% dei casi senza informazioni complete.
Lara Maior


Scienza IT&C
Yarrrrrbright/ Shutterstock.com

Guarda sempre le nostre notizie su Google
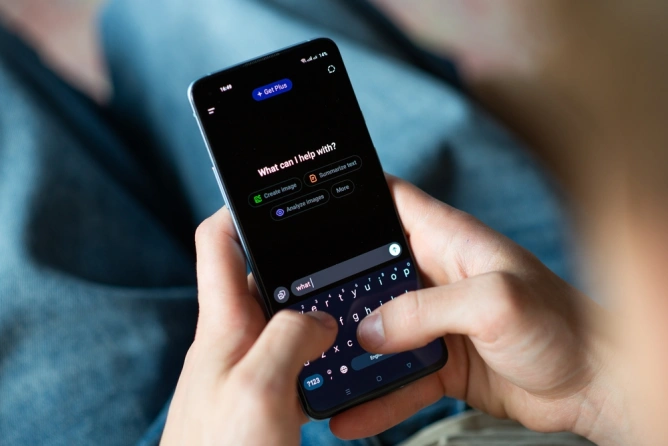
Uno studio condotto da Mass General Brigham nel Massachusetts, pubblicato in Jama Network Open, ha evidenziato che i chatbot comuni, come ChatGPT e Gemini, commettono errori diagnostici in oltre l'80% dei casi quando non hanno informazioni sufficienti sui pazienti. Lo studio ha testato 21 modelli linguistici, inclusi quelli sviluppati da OpenAI, Anthropic, Google, xAI e DeepSeek, utilizzando 29 vignette cliniche basate su testi medici di riferimento. Anche quando avevano accesso a informazioni complete, i chatbot avevano un tasso di errore superiore al 40%, sebbene in alcuni casi siano riusciti a fornire la diagnosi corretta per il 90% dei pazienti. La conclusione degli esperimenti è che le prestazioni di questi modelli dipendono significativamente dal volume di informazioni disponibili, e le allucinazioni, ovvero l'invenzione di informazioni, rimangono un problema importante nella generazione di risposte corrette.
Fonti


Ultime notizie
21:18
Il PNL voterà per la riduzione del numero dei parlamentari e l’abolizione delle pensioni speciali degli eletti locali
21:16
Gli organizzatori del Gran Premio di Spagna di Formula 1 modificheranno il circuito del Madring, dopo una gara con pochi sorpassi
21:10
Nicușor Dan ha trasmesso alla comunità ebraica un messaggio per il Capodanno ebraico e ha sottolineato il suo contributo alla società rumena
21:04
La maggioranza degli Stati UE sostiene drastici tagli alla spesa per il personale nei negoziati sul bilancio comunitario 2028-2034
21:03
Il Senato propone di verificare elettronicamente la qualità di assicurato, senza certificato cartaceo, attraverso i sistemi della CNAS
Vedi altre notizie
NOTIZIE SUGLI STESSI ARGOMENTI
Internazionale
ChatGPT, Gemini, Claude e Grok hanno subito interruzioni / Migliaia di utenti hanno segnalato problemi in oltre 70 Paesi
Internazionale
ChatGPT, la piattaforma di intelligenza artificiale di OpenAI, sta affrontando un'interruzione maggiore
Internazionale
Tre giovani inesperti sono rimasti bloccati sul Monte Shasta, in California, dopo aver seguito consigli errati forniti da Gemini

Feed di notizie personalizzato, ricerca con AI e notifiche in un’esperienza più interattiva.