Eine Studie zeigt, dass medizinische Chatbots, einschließlich ChatGPT und Gemini, in 80% der Fälle falsche Diagnosen stellen, ohne vollständige Informationen.
Lara Maior


IT&C-Wissen
Yarrrrrbright/ Shutterstock.com

Sieh unsere Nachrichten immer auf Google
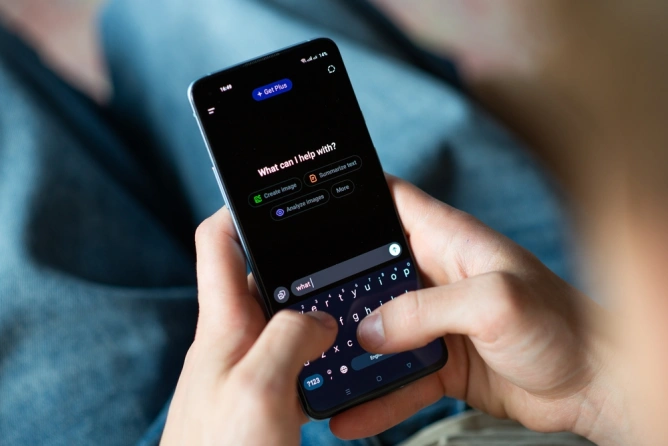
Eine Studie von Mass General Brigham aus Massachusetts, veröffentlicht in Jama Network Open, hat gezeigt, dass gängige Chatbots wie ChatGPT und Gemini in über 80 % der Fälle falsche Diagnosen stellen, wenn sie nicht genügend Informationen über die Patienten haben. Die Studie testete 21 Sprachmodelle, darunter die von OpenAI, Anthropic, Google, xAI und DeepSeek entwickelt wurden, unter Verwendung von 29 klinischen Vignetten, die auf medizinischen Referenztexten basieren. Selbst wenn sie Zugang zu vollständigen Informationen hatten, hatten die Chatbots eine Fehlerquote von über 40 %, obwohl sie in einigen Fällen in der Lage waren, die richtige Diagnose für 90 % der Patienten zu stellen. Die Schlussfolgerung der Experimente ist, dass die Leistung dieser Modelle erheblich von der Menge der verfügbaren Informationen abhängt und Halluzinationen, also das Erfinden von Informationen, ein großes Problem bei der Generierung korrekter Antworten bleiben.
Quellen


Neueste Nachrichten
22:02
Donald Trump befördert Stephen Miller zum Stabschef im Weißen Haus
21:29
Die Präsidentin des Bayerischen Landtags für die Präsidentschaft Deutschlands unterstützt / Die Nominierung der CSU-Politikerin könnte am Montag bestätigt werden
21:28
Sviatlana Tichanowskaja hat in Timișoara den Preis für europäische Werte erhalten und wird das Preisgeld für die belarussische Kultur spenden
20:57
Dmitri Medwedew beschuldigt Elon Musk, durch die Bereitstellung von Starlink-Diensten zu einem Teilnehmer am Krieg in der Ukraine geworden zu sein
20:52
Copernicus schätzt, dass die globale Temperatur im Jahr 2026 um mehr als 1,5 °C über dem vorindustriellen Niveau liegen wird
Mehr Nachrichten ansehen
NACHRICHTEN ZU DENSELBEN THEMEN

Personalisierter Nachrichten-Feed, KI-gestützte Suche und Benachrichtigungen in einem interaktiveren Erlebnis.