中国公司利用 ChatGPT 的回答来开发更便宜且更易于使用的 AI 模型
Sanziana Georgescu


.webp)
国际
Steagul Chinei; Unsplash

始终在 Google 上查看我们的新闻
据路透社在北京与华盛顿科技竞争加剧之际发表的一项调查,中国企业正在利用美国人工智能模型生成的回答来训练自有系统,以打造成本更低、更加便于整合到工业领域的人工智能系统。
这种被称为“蒸馏”的做法,是利用高性能模型生成回答、代码或复杂问题的解决方案。随后,这些成果会被转化为训练数据,用于训练规模更小的模型,使其能够复制原系统的部分能力。
这项调查分析了300多篇科学论文、专利、政府文件和企业材料,显示该方法正越来越多地被中国工业界采用。2024年,上海交通大学的研究人员选取了OpenAI o1模型生成的约5,000条回答,并将其转化为10,000多个双语示例,用于训练阿里巴巴开发的Qwen2.5-72B模型。
2025年4月,阿里巴巴研究人员使用GPT-4和GPT-4o生成多种语言的训练数据。2026年2月,大学研究人员与美团员工介绍了一种基于GPT-4o的方法,用于训练能够协调人工智能编程代理的模型。
蒸馏本身并不违法,但OpenAI和Anthropic限制使用其模型的输出开发竞争性系统。美国官员在7月于成都与中国官员举行的会谈中提出了这一问题。北京方面表示,这项技术属于常见做法,并承诺在证实存在盗用的情况下采取行动。
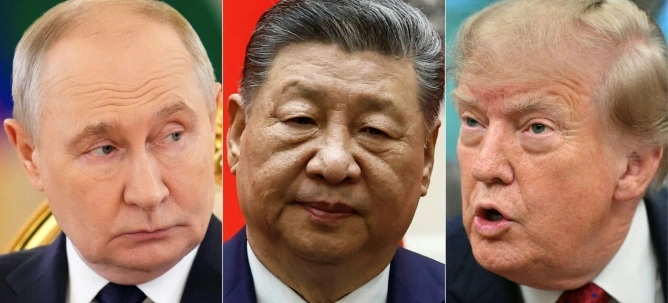
这场争端发生在美国宣布进一步限制中国获取先进芯片(包括英伟达产品)之后。与此同时,北京支持开发规模更小的模型,这些模型所需的计算能力较低,并可用于工厂。唐纳德·特朗普与习近平可能在计划于11月18日至19日于深圳举行的亚太经合组织峰会上讨论这些分歧。
на来源


最新新闻
同一主题的新闻
.webp)

个性化新闻推送、AI搜索与通知,更具互动性的体验。