



Un studiu arată că chatboții medicali, inclusiv ChatGPT și Gemini, oferă diagnostice greșite în 80% din cazuri fără informații complete
Lara Maior


Știință IT&C
Yarrrrrbright/ Shutterstock.com

Vezi mereu știrile noastre în Google
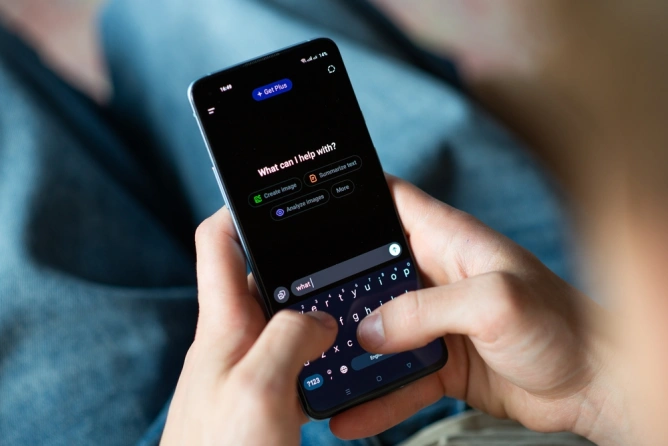
Un studiu realizat de Mass General Brigham din Massachusetts, publicat în Jama Network Open, a evidențiat că chatboții obișnuiți, precum ChatGPT și Gemini, greșesc diagnosticele în peste 80% din cazuri atunci când nu au suficiente informații despre pacienți. Studiul a testat 21 de modele lingvistice, inclusiv cele dezvoltate de OpenAI, Anthropic, Google, xAI și DeepSeek, folosind 29 de viniete clinice bazate pe texte medicale de referință. Chiar și atunci când au avut acces la informații complete, chatboții au avut o rată a erorilor de peste 40%, deși în unele cazuri au reușit să ofere diagnosticul corect pentru 90% dintre pacienți. Concluzia experților este că performanța acestor modele depinde semnificativ de volumul de informații disponibile, iar halucinațiile, adică inventarea de informații, rămân o problemă majoră în generarea de răspunsuri corecte.
Surse


Ultimele știri
14:36
Prețul petrolul în creștere / Brent se apropie de maximul ultimelor cinci luni pe fondul tensiunilor din Orientul Mijlociu
14:35
Diana Șoșoacă susține că limba latină s-ar trage din română și că Vaticanul ar fi confirmat teoria
14:26
Benjamin Netanyahu ordonă izolarea Cisiordaniei după atacul armat de la Hebron, soldat cu cinci răniți și doi atacatori uciși
14:24
Un fost premier contestă explicațiile Ministerului Finanțelor privind deficitul bugetar: ”Încearcă să inducă în eroare opinia publică”
14:16
Transgaz și Kawasaki vor testa în România transportul pe scară largă al hidrogenului pur prin conducte onshore
Vezi mai multe știri
ȘTIRI PE ACELEAȘI SUBIECTE

Feed personalizat de știri, căutare cu Inteligență Artificială și notificări într-o experiență mai interactivă.