中国企業はChatGPTの回答を利用して、より安価で使いやすいAIモデルを開発している


.webp)

Googleでいつでも私たちのニュースを見る
中国企業は、米国の人工知能モデルが生成した回答を自社システムの訓練に利用している。これにより、より安価で産業に統合しやすいシステムを開発しているという。北京とワシントンの技術競争が激化する中、Reutersが行った調査で明らかになった。
「蒸留」と呼ばれるこの手法では、高性能モデルを使って回答やコード、複雑な問題への解決策を生成する。これらの成果物を訓練データに変換し、元のシステムの能力の一部を再現できる、より小規模なモデルを開発する。
300本を超える科学論文、特許、政府文書、企業資料を分析した今回の調査によると、この手法は中国の産業界でますます利用されている。2024年には、上海交通大学の研究者がOpenAIのo1モデルによって生成された約5,000件の回答を選び出し、それらを10,000件超のバイリンガル例に変換して、Alibabaが開発したQwen2.5-72Bモデルの訓練に使用した。
2025年4月には、Alibabaの研究者がGPT-4とGPT-4oを使い、複数言語の訓練データを生成した。2026年2月には、大学の研究者とMeituanの従業員が、プログラミングにおいてAIエージェントを調整できるモデルの準備にGPT-4oを利用する手法を発表した。
蒸留自体は違法ではないが、OpenAIとAnthropicは、自社モデルの出力を競合システムの開発に利用することを制限している。米国当局は7月、成都で中国当局と協議した際、この問題を提起した。北京は、この技術は一般的なものだと主張し、窃盗が立証されたケースには介入すると約束している。
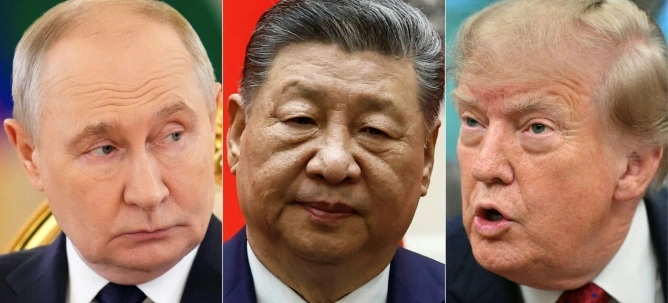
この対立は、米国がNvidia製品を含む先端半導体への中国のアクセスに関する新たな規制を発表した後に起きている。一方、北京は、より少ない計算能力で動作し、工場で利用できる小規模モデルの開発を支援している。相違点は、11月18~19日に深圳で予定されているAPEC首脳会議で、Donald Trump氏とXi Jinping氏が協議する可能性がある。
,ソース


最新ニュース
08:53
08:50
08:40
08:33
08:24
さらにニュースを見る
同じテーマのニュース
.webp)